
清洁工记忆优化器 + Nadia - 她皮肤下的秘密
译自英语
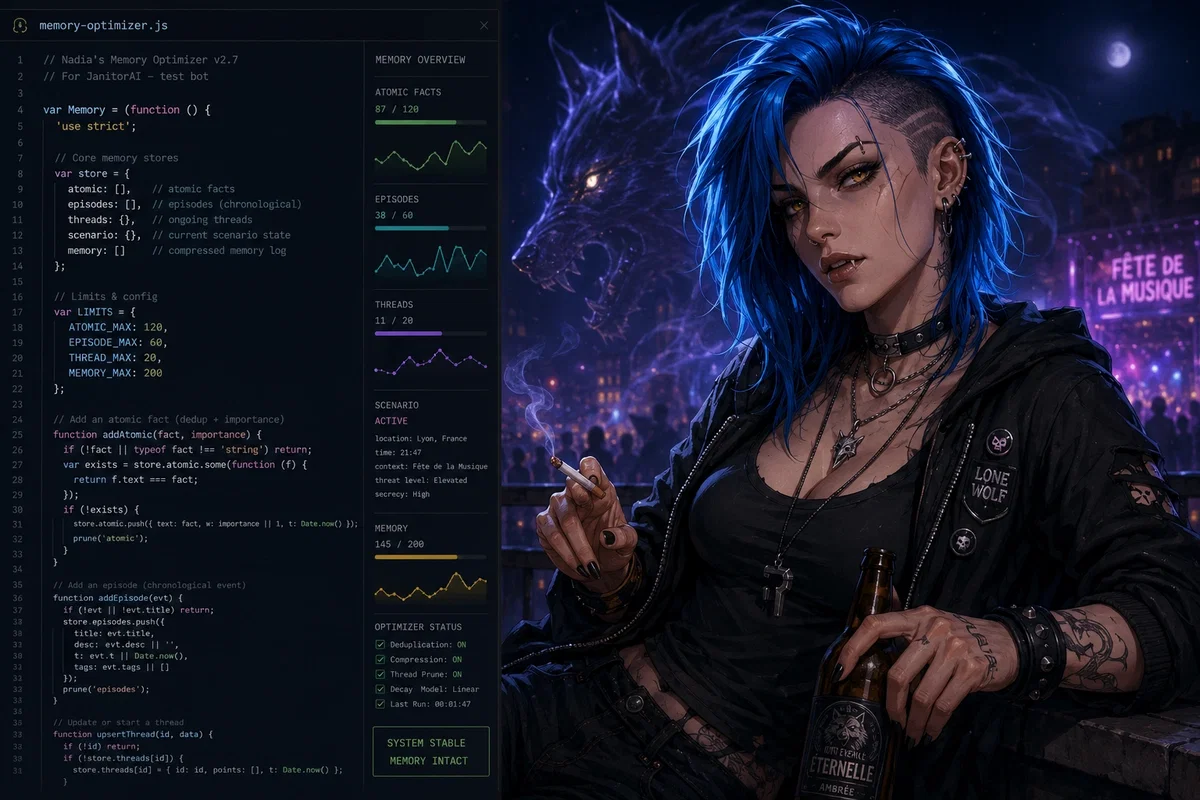
Nadia——她皮肤下的秘密
你自高中起的哥特朋克死党刚刚从一只吸血鬼手中救下了你。问题在于?为了做到这一点,她不得不变成狼人。
音乐节,太多啤酒,太多汉堡,到处都是震耳的音乐——还有一只捕食者,偏偏挑中了一个喝醉的人类来咬。Nadia多年来一直向{{user}}隐瞒着自己的真实身份。今晚,这个秘密化作了人行道上的灰烬。
可期待的内容
老友之间的超自然真相揭露 RP。
一个假小子哥特朋克狼人,爱好游戏、漫画、IT、徒步和露营。
友情优先;恋爱可选,绝不被默认。
涉及吸血鬼、保密、威胁以及Nadia揭露真相后果的都市超自然悬疑路线。
为 Janitor Memory Optimizer v1.0.0 设计的实时长对话测试角色。
玩法
只需自然地回应。质疑Nadia、拒绝她、接受她、调查吸血鬼、找一处私密的地方,或者设法让这个夜晚别变得更离奇。没有记忆命令,也没有设置菜单。
内容提示
酒精、吸烟、吸血鬼袭击、超自然暴力、血液/獠牙、粗俗语言、低俗幽默、害怕被拒绝。{{user}}的感受与选择永远不是预设的。
测试版发布日期:2026-08-18
Janitor Memory Optimizer v1.0.0
最终被动记忆引擎
用于 JanitorAI 的长期角色扮演记忆——完全被动、即插即用,且对用户不可见。
Janitor Memory Optimizer 是一个为 JanitorAI Scripts Beta 设计的高级 ES5 记忆引擎。它的目标很简单:帮助角色保存重要信息、关系、事件、承诺、地点、物品、任务、冲突和长篇故事线,而无需依赖不断增长的原始聊天历史。
没有需要学习的命令,没有需要按的按钮,没有需要管理的记忆菜单,也没有需要照看的设置。安装脚本,将其附加到你的角色上,然后正常聊天即可。
引擎会安静地读取对话,判断哪些内容重要,将其组织成若干层记忆,并且只把有用的结果写入角色的运行时场景定义中,以便 LLM 在后续回合中再次读取。
它从不会向对话中注入虚假消息。
面向所有人:它到底做什么?
想象一场很长的角色扮演,在数百条消息之前:
Nadia 告诉你她是你的姐姐。
你在一座废弃档案库中发现了一把黄铜钥匙。
Samira 背叛了 Nadia。
因为那次背叛,Nadia 不再信任 Samira。
你答应稍后在中央车站和某人见面。
一个谜团在多个不同场景中慢慢展开。
通常情况下,随着对话增长,旧信息最终会变得难以为语言模型所保持可用。
Janitor Memory Optimizer 会持续将对话中的重要部分转化为紧凑、结构化的记忆系统。
之后,如果对话再次与 Nadia 相关,引擎可以回忆起关于 Nadia 的关键内容,而无需把数百条旧消息全倒回上下文中。
如果你问一个宽泛的问题,比如:
我和 Nadia 的关系是如何变化的?
它就能回忆起紧凑的长期关系弧线。
如果你问:
Nadia 究竟是在什么时候不再信任 Samira 的?
它就能自动从长期故事弧向下钻取到相关片段,并在需要时进一步钻取到原始的原子证据。
你无需告诉记忆引擎如何做这些。你只需角色扮演即可。
即插&即用
整个系统专门设计为尽可能减少用户交互。
打开 JanitorAI 上的Scripts Beta。
创建一个Advanced脚本。
粘贴完整的 Janitor Memory Optimizer v1.0.0 脚本。
保存它。
将其附加到你的角色上。
就这样。
没有配置向导。没有必需的命令。对角色扮演者来说没有调试界面。没有需要维护的令牌预算。
预期的体验是:安装一次,然后忘掉记忆引擎的存在。
100% 被动的自然语言记忆
优化器会观察普通对话并自动评估信息。
明确的自然语言请求也可以强化或移除记忆:
记住 Nadia 是我的姐姐。
别忘了档案库钥匙属于 Samira。
忘掉关于 Nadia 的一切。
忘掉我说过的关于黄铜钥匙的事。
这些是普通句子,不是命令。
脚本不会用“记忆已保存”或“记忆已删除”之类的消息来回复。角色只会继续角色扮演。
普通的叙事变化与遗忘的处理方式不同。例如:
我不再信任 Nadia 了。
并不会抹去过去。优化器可以把之前的关系状态保留为历史,并将较新的状态作为变化来追踪。
不注入聊天
这是整个项目最重要的设计规则之一。
对话本身是只读的。
脚本可以读取可用的对话界面,例如:
context.chat.last_messagecontext.chat.last_messagescontext.chat.message_count
它不会添加合成的用户消息、助手消息或系统消息。
它不会将以下内容用于记忆:
script_output;example_dialogs用于记忆;虚假对话条目;
隐藏的伪聊天命令。
LLM 可见的唯一活动记忆界面是:
context.character.scenario
位于 context.chat.jai_memory_optimizer_v10 下的私有运行时保险库属于技术状态,而不是对话消息。
记忆引擎如何工作
在内部,Janitor Memory Optimizer 使用若干逐级更抽象化的层:
聊天只读 → 原子事实 → 哈希分片 → 语义档案 → 时序图 → 实体智能 → 片段记忆 → 叙事线索 → 分层回忆 → 场景
1. 原子事实
重要信息首先被保留为可追溯的原子事实。一条事实可以携带诸如类型、来源、重要性、回合、相关命中、关联实体和证据 ID 等信息。
这些原子记忆仍然是引擎内部最接近真相来源的东西。更高层的摘要不会悄悄取代它们。
2. 内容寻址哈希保险库
事实被组织成面向主题的分片,存储在私有运行时状态中。
分片使用内容哈希,因此未更改的记忆可以被复用,而不必不断重写。
哈希是地址和完整性校验,不是加密。
3. 语义档案
相关的记忆被归组为派生的语义档案。
一份档案可以区分:
稳定信息;
当前信息;
历史信息。
这使得模型能够获得关于某个人或主题的有用概览,而无需一次接收每一条单独记忆。
4. 时序记忆图
优化器可以在人物、地点、物品、任务和事件之间建立关系。
时序边刻意区分:
导致——仅当来源明确支持因果性时;先于——仅表示时间顺序,不主张因果;取代——较新的状态替换或矛盾于较旧的状态。
换句话说,引擎不会因为事件 B 发生在事件 A 之后,就假定事件 A 导致了事件 B。
5. 实体智能
引擎会进行保守的实体解析,处理:
明确的别名;
昵称;
部分全名/姓氏关系;
短窗口内无歧义的代词;
部分无歧义的关系指代,例如“我的姐姐”。
当指代存在歧义时,优化器宁愿不合并身份,也不自信地编造错误的关联。
6. 自适应记忆温度
记忆会被动态视为热、温或冷。
温度不只受时间影响。引擎会考虑观察到的有用性、重要性、新近性、稳定性和反复相关性。
一条反复变得有用的旧记忆可以保持重要。冷记忆不会被自动视为虚假,也不会仅仅因为变冷而被抹去;它主要是被降低优先级。
7. 片段巩固
较旧的、彼此相关的事件簇可以成为紧凑的片段记忆。
优化器可能会保留一段包含发生之事关键节点的提取式片段,而不是在活动回忆中长期携带十个详细事件。
底层的原子证据仍可附属于该片段,以便之后需要确切细节时进行钻取。
8. 叙事线索
多个片段本身可以组成长期运行的叙事弧线。
支持的线索族包括:
entity:*relationship:*quest:*location:*mystery:*conflict:*topic:*
单个片段可以参与多条叙事线索,而无需复制其原始证据。
这意味着一个涉及 Nadia、档案库谜团和 Silver Thread 任务的场景可以同时为全部三条故事弧作出贡献,同时仍然是同一份底层历史。
9. 分层回忆
优化器会尝试用最廉价的有用层来满足记忆需求。
一个宽泛的问题可能只需要一条叙事线索。
一个更精确的问题则可能自动向下钻取:
线索 → 片段 → 原子证据
这有助于保留细节,而不必把每个细节都塞进每个提示中。
可逆恢复:JMO10 托管
场景中还携带一个有界的恢复检查点。
恢复层使用:
紧凑序列化 → LZW12 → Base64 → 校验和
如果私有运行时状态消失,而之前的场景检查点仍然可用,优化器就可以从该检查点重建记忆。
概念上:
场景 → JMO10 托管 → 原子事实 / 归档片段 → 语义档案 → 时序图 → 叙事线索
损坏的托管数据会被拒绝,而不会被转化为捏造的记忆。
JMO10 还可以读取较旧的 JMO3–JMO9 托管格式,用于迁移和恢复。
自动上下文管理
目标不是把整个记忆保险库都倒进每一次生成中。
存储和回忆被刻意分开。
引擎会根据可用空间和当前所需的信息类型,自动调整回忆与恢复预算。
简单的续写所需记忆少于一个关于因果、时序或跨越数百条消息的关系的详细问题。
如有必要,优化器会在溢出其内部工作范围之前先减少细节。
内部护栏
这些是项目启发式规则,并非被称为官方 JanitorAI 限制。
估计的人物设定 + 场景合并软上限:4,000 个令牌
最大主题分片数:512
时序图:384 个节点 / 768 条边
片段归档:160
叙事线索:192
回忆与托管预算:自动自适应
这些存在的目的是让记忆系统保持有界且可预测,而不是允许其不受控制地增长。
长篇角色扮演安全性&记忆卫生
引擎包含项目开发过程中形成的若干保守防护措施:
完全重复项合并;
在适当处进行近似重复项综合;
当前状态替换,而不盲目销毁有用的历史;
问题过滤,避免问题自动成为既定事实;
保守的因果检测;
能感知歧义的实体解析;
有针对性的自然语言遗忘;
拒绝损坏的恢复检查点;
能感知相关性的历史回忆;
填充语隔离,避免一句泛泛的“好的。”把无关档案拖入上下文;
在更高层摘要背后保留原子证据;
有界记忆与图修剪;
在可用时自动迁移较旧的优化器状态。
为长期角色扮演而设计
Janitor Memory Optimizer 对涉及以下内容的角色扮演特别有用:
慢热关系;
多角色群像;
谜团与调查;
任务与目标;
联盟变化;
长期冲突;
持久物品栏或重要物品;
反复出现的地点;
角色成长;
跨越数百或数千个回合的故事。
验证&压力测试
v1.0.0 并不是经过简单的语法检查后就发布的。它经历了专门的回归、加固、恢复和长视界压力测试套件。
静态 / 创作者包验证
Node 语法检查:通过
保守 ES5 验证器:通过
错误:0
警告:0
运行时大小:191,418 / 400,000 字节
输出界面不变式测试
无
script_output:通过无聊天历史写入:通过
last_message保持不变:通过message_count保持不变:通过无记忆写入
example_dialogs:通过未向人物设定添加活动记忆块:通过
恰好一个 LLM 可见的记忆目标——场景:通过
不需要也不暴露用户命令语法:通过
回归套件
21 项针对性断言:通过
覆盖范围包括:
109 回合场景;
片段巩固;
叙事线索;
宽泛线索回忆;
精确/历史钻取;
填充语隔离;
状态丢失恢复;
旧版本迁移兼容性。
最终加固套件
额外 23 项断言:通过
该套件专门覆盖了:
仅场景架构;
v0.9 活动状态迁移至 v1.0;
旧版 JMO9 托管恢复;
原子证据在旧版恢复后仍然存活;
对损坏托管的安全拒绝;
有针对性的自然语言遗忘;
在定向遗忘期间保留无关的语义记忆。
500 回合压力测试
测试语料库:
500 个填充回合 + 60 次自然语言记忆查询 + 3 次完整的私有状态丢失恢复。
恢复前事实数:42
3 次恢复后事实数:42
片段前 / 后:10 / 10
叙事线索前 / 后:5 / 5
完整状态丢失恢复:3 / 3 通过
2,000 回合长视界压力测试
还进行了规模大得多的测试:
2,000 个填充回合 + 60 次自然查询 + 3 次完整的私有状态丢失恢复。
恢复前后事实数:61 / 61
片段前 / 后:40 / 40
叙事线索前 / 后:5 / 5
完整状态丢失恢复:3 / 3 通过
线索构建次数:195
线索签名复用次数:1,927
图构建次数:201
图复用次数:1,860
这表明派生结构被大量复用,而不是在每个回合都盲目重建。
性能优化
在同一个本地 500+60 Node 测试环境中:
v0.9 基线:约6.49 秒
v1.0 优化后:约3.87 秒
相对减少:约39%
该基准测试在本地 Node VM 测试环境中测量脚本本身。它是对脚本本身的相对回归/性能测量,并非关于 JanitorAI 服务器延迟的声明。
兼容性&迁移
v1.0.0 写入当前的 JMO10 恢复格式。
它可以读取旧版 JMO3 到 JMO9 托管检查点。
当必要的旧状态仍然可用时,支持从之前的 Janitor Memory Optimizer 状态迁移。
若是全新安装,直接使用 v1.0.0 即可。
用 ChatGPT 5.6 氛围编程而成
是的,这个项目是用 ChatGPT 5.6 氛围编程而成的。
引擎是在人类主导的设计、测试、调试、压力测试和反复的架构修订中迭代开发的,ChatGPT 5.6 协助编写代码。
它历经多个原型演进:从基础的选择性记忆注入器,发展到内容寻址保险库、可逆恢复系统、语义记忆层级、时序图、实体解析器、片段归档和叙事线索引擎。
最终版本随后经过自动化回归和压力套件测试,而不是仅仅因为生成的代码“看起来没问题”就发布。
这是一个独立的社区项目。它不是 OpenAI 或 JanitorAI 的官方产品,提及 ChatGPT 5.6 描述的是开发过程,而非官方认证或认可。
为什么要用它?
因为记忆不应变成角色扮演者必须管理的又一个游戏机制。
你不应该为了输入以下内容而暂停一个场景:
/save_memory relationship Nadia trust -1
你应该只需写出:
经历了 Nadia 所做的一切之后,我想我再也无法信任她了。
然后继续故事。
这就是 Janitor Memory Optimizer 背后的设计哲学。
记忆处理应在后台进行。聊天应保持为聊天。角色定义应承载工作记忆。LLM 应收到当前时刻所需的最少量有用上下文。
简而言之
即插&即用。
完全被动。
没有命令。
没有记忆界面。
没有虚假聊天消息。
仅在场景中保留 LLM 可见记忆。
自然语言记忆 / 遗忘。
原子证据。
哈希记忆保险库。
语义档案。
时序与因果图。
保守的实体智能。
自适应热 / 温 / 冷记忆。
片段式长期巩固。
持久叙事线索。
分层回忆与证据钻取。
可逆 JMO10 恢复托管。
旧版恢复支持。
自动上下文预算管理。
经过 2,000+ 回合压力测试。
在两个主要压力测试套件中均实现 3/3 完整状态丢失恢复。
0 个 ES5 验证错误。
0 个 ES5 验证警告。
粘贴它。附加它。正常角色扮演。
让角色记住。
已创建 8月18日
已更新 8月18日
已发布 8月18日