
Otimizador de Memória do Zelador + Nadia - O Segredo Sob a Pele Dela
Traduzido do inglês
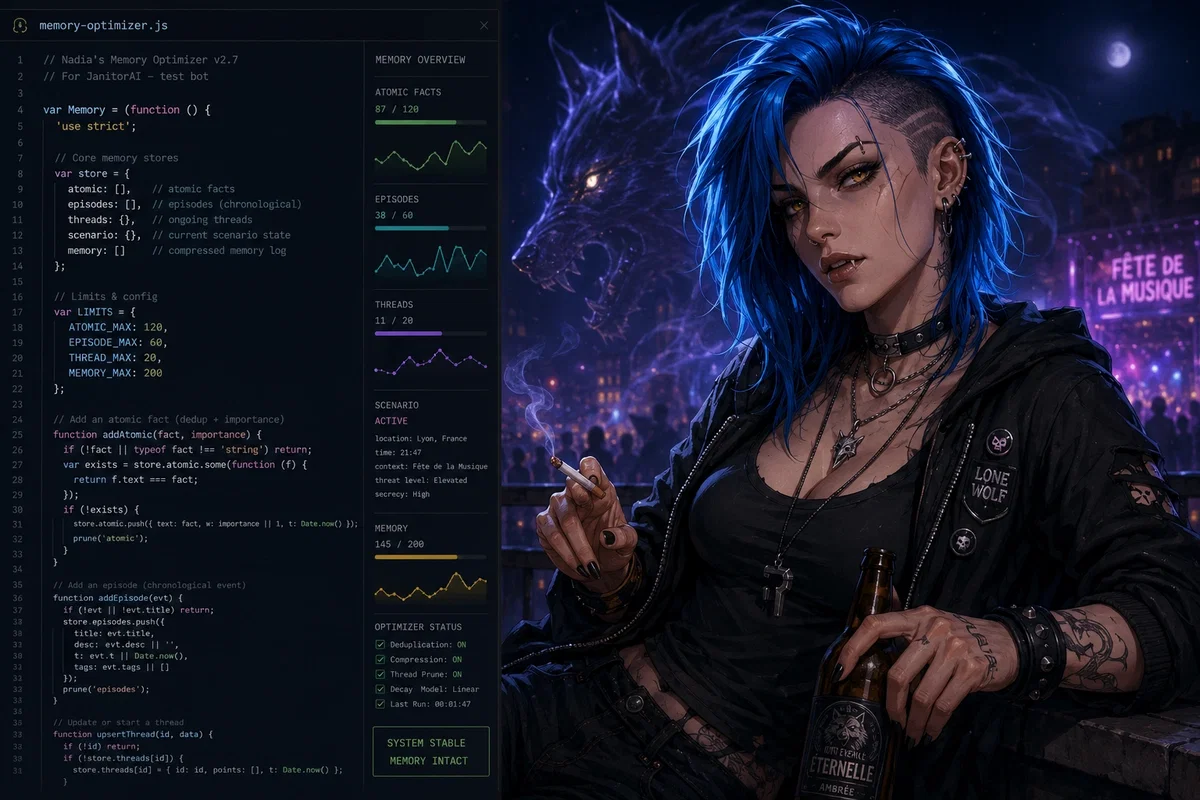
by:@Myrakiel
Nadia — O Segredo Sob a Pele Dela
Sua melhor amiga gótico-punk desde o colégio acabou de te salvar de um vampiro. O problema? Ela teve que se tornar uma lobisomem para fazer isso.
Fête de la Musique, cerveja demais, hambúrgueres demais, música alta por todo lado — e um predador que escolheu o humano bêbado errado para morder. Nadia passou anos escondendo o que realmente é de {{user}}. Hoje à noite, esse segredo virou cinzas no asfalto.
O Que Esperar
RP de revelação sobrenatural entre amigos de longa data.
Uma licantropa gótico-punk moleca com interesses em jogos, quadrinhos, TI, trilhas e acampamentos.
Amizade em primeiro lugar; romance é opcional e nunca presumido.
Rotas de mistério sobrenatural urbano envolvendo vampiros, sigilo, ameaças e as consequências da revelação de Nadia.
Projetado como um personagem de teste de chat longo ao vivo para o Janitor Memory Optimizer v1.0.0.
Como Jogar
Apenas responda naturalmente. Questione Nadia, rejeite-a, aceite-a, investigue o vampiro, vá para algum lugar privado, ou tente impedir que a noite fique ainda mais estranha. Não há comandos de memória nem menus de configuração.
Notas de Conteúdo
Álcool, fumo, ataque de vampiro, violência sobrenatural, sangue/presas, linguagem grosseira, humor vulgar, medo da rejeição. {{user}}Os sentimentos e escolhas de nunca são predeterminados.
Versão de teste: 2026-08-18
Janitor Memory Optimizer v1.0.0
Motor de Memória Passiva Final
Memória de roleplay de longo prazo para o JanitorAI — totalmente passiva, plug-and-play e invisível para o usuário.
O Janitor Memory Optimizer é um motor de memória ES5 avançado projetado para o JanitorAI Scripts Beta. Seu objetivo é simples: ajudar um personagem a preservar informações importantes, relacionamentos, eventos, promessas, locais, objetos, missões, conflitos e arcos de história de longa duração sem depender de um histórico de chat bruto cada vez maior.
Não há comandos para aprender, nem botões para apertar, nem menu de memória para gerenciar e nem configuração para cuidar. Instale o script, anexe-o ao seu personagem e converse normalmente.
O motor lê silenciosamente a conversa, decide o que importa, organiza em várias camadas de memória e grava apenas o resultado útil no runtime Cenário do personagem para que o LLM possa lê-lo novamente em turnos futuros.
Ele nunca injeta mensagens falsas na conversa.
Para Todos: O Que Ele Realmente Faz?
Imagine um roleplay longo em que, centenas de mensagens atrás:
Nadia te contou que era sua irmã.
Você descobriu uma chave de latão em um arquivo abandonado.
Samira traiu Nadia.
Nadia parou de confiar em Samira por causa dessa traição.
Você prometeu encontrar alguém mais tarde na Estação Central.
Um mistério se desenvolveu lentamente ao longo de várias cenas diferentes.
Normalmente, informações antigas eventualmente se tornam difíceis de um modelo de linguagem manter disponíveis conforme a conversa cresce.
O Janitor Memory Optimizer transforma continuamente partes importantes da conversa em um sistema de memória compacto e estruturado.
Mais tarde, se a conversa se tornar relevante para Nadia novamente, o motor pode recordar o que importa sobre Nadia sem despejar centenas de mensagens antigas de volta no contexto.
Se você fizer uma pergunta ampla como:
Como meu relacionamento com Nadia mudou?
ele pode recordar o arco de relacionamento de longo prazo compacto.
Se você perguntar:
Quando exatamente Nadia parou de confiar em Samira?
ele pode automaticamente aprofundar do arco de história de longo prazo para o episódio relevante e, quando necessário, para a evidência atômica original.
Você não diz ao motor de memória como fazer nada disso. Você simplesmente faz roleplay.
Plug & Play
Todo o sistema foi especificamente projetado para exigir o mínimo possível de interação do usuário.
Abra Scripts Beta no JanitorAI.
Crie um script Avançado.
Cole o script completo do Janitor Memory Optimizer v1.0.0.
Salve-o.
Anexe-o ao seu personagem.
É isso.
Não há assistente de configuração. Não há comandos obrigatórios. Não há interface de depuração para o roleplayer. Não há orçamentos de tokens manuais para manter.
A experiência pretendida é: instale uma vez, depois esqueça que o motor de memória existe.
Memória em Linguagem Natural 100% Passiva
O otimizador observa a conversa comum e avalia as informações automaticamente.
Pedidos explícitos em linguagem natural também podem fortalecer ou remover memórias:
Lembre que Nadia é minha irmã.
Não esqueça que a chave do arquivo pertence a Samira.
Esqueça tudo sobre Nadia.
Esqueça o que eu disse sobre a chave de latão.
Estas são frases normais, não comandos.
O script não responde com mensagens como "Memória salva" ou "Memória apagada." O personagem simplesmente continua o roleplay.
Mudanças narrativas comuns são tratadas de forma diferente de esquecimento. Por exemplo:
Não confio mais em Nadia.
não apaga o passado. O otimizador pode preservar o estado anterior do relacionamento como histórico e rastrear o estado mais novo como uma mudança.
Sem Injeção no Chat
Esta é uma das regras de design mais importantes de todo o projeto.
A própria conversa é somente leitura.
O script pode ler superfícies de conversa disponíveis como:
context.chat.last_messagecontext.chat.last_messagescontext.chat.message_count
Ele não adiciona mensagens sintéticas de usuário, mensagens de assistente ou mensagens de sistema.
Ele não usa:
script_outputpara memória;example_dialogspara memória;entradas falsas de conversa;
comandos pseudo-chat ocultos.
A única superfície de memória ativa visível ao LLM é:
context.character.scenario
O cofre privado de runtime em context.chat.jai_memory_optimizer_v10 é estado técnico, não uma mensagem de conversa.
Como o Motor de Memória Funciona
Internamente, o Janitor Memory Optimizer usa várias camadas progressivamente mais abstratas:
Leitura do chat somente leitura → Fatos Atômicos → Fragmentos com Hash → Dossiês Semânticos → Grafo Temporal → Inteligência de Entidades → Memória Episódica → Fios Narrativos → Recordação Hierárquica → Cenário
1. Fatos Atômicos
Informações importantes são primeiro retidas como fatos atômicos rastreáveis. Um fato pode carregar informações como seu tipo, fonte, importância, turno, ocorrências de relevância, entidades associadas e ID de evidência.
Essas memórias atômicas permanecem a coisa mais próxima de uma fonte de verdade dentro do motor. Resumos de nível superior não as substituem silenciosamente.
2. Cofre com Hash Endereçado por Conteúdo
Os fatos são organizados em fragmentos orientados por tópicos armazenados em estado privado de runtime.
Os fragmentos usam hashes de conteúdo para que memória inalterada possa ser reutilizada em vez de constantemente reescrita.
Os hashes são endereços e verificações de integridade, não criptografia.
3. Dossiês Semânticos
Memórias relacionadas são agrupadas em perfis semânticos derivados.
Um dossiê pode distinguir:
informações estáveis;
informações atuais;
informações históricas.
Isso permite que o modelo receba uma visão geral útil de uma pessoa ou tópico sem receber cada memória individual de uma vez.
4. Grafo de Memória Temporal
O otimizador pode construir relacionamentos entre pessoas, lugares, objetos, missões e eventos.
As arestas temporais distinguem deliberadamente:
causas— apenas quando a fonte apoia explicitamente a causalidade;precede— ordem cronológica sem alegar causalidade;substitui— um estado mais novo substituindo ou contradizendo um mais antigo.
Em outras palavras, o motor não assume que, porque o Evento B aconteceu depois do Evento A, o Evento A causou o Evento B.
5. Inteligência de Entidades
O motor realiza resolução conservadora de entidades para:
aliases explícitos;
apelidos;
algumas relações de nome completo / nome de família;
pronomes inequívocos de janela curta;
algumas referências de relacionamento inequívocas como "minha irmã."
Quando uma referência é ambígua, o otimizador prefere não mesclar identidades em vez de inventar com confiança a conexão errada.
6. Temperatura de Memória Adaptativa
As memórias são dinamicamente tratadas como quentes, mornas ou frias.
A temperatura é influenciada por mais do que a idade. O motor considera utilidade observada, importância, recência, estabilidade e relevância repetida.
Uma memória antiga que repetidamente se torna útil pode permanecer importante. Uma memória fria não é automaticamente considerada falsa e não é apagada simplesmente por ser fria; ela é principalmente despriorizada.
7. Consolidação Episódica
Aglomerados mais antigos de eventos relacionados podem se tornar memórias episódicas compactas.
Em vez de carregar permanentemente dez eventos detalhados na recordação ativa, o otimizador pode preservar um episódio extrativo contendo os momentos-chave do que aconteceu.
A evidência atômica subjacente pode permanecer anexada a esse episódio, permitindo aprofundamento posterior quando detalhes exatos forem necessários.
8. Fios Narrativos
Múltiplos episódios podem eles próprios se tornar arcos narrativos de longa duração.
Famílias de fios suportadas incluem:
entity:*relationship:*quest:*location:*mystery:*conflict:*topic:*
Um único episódio pode participar de vários fios narrativos sem duplicar sua evidência original.
Isso significa que uma cena envolvendo Nadia, um mistério de arquivo e a missão do Fio de Prata pode contribuir para todos os três arcos de história enquanto permanece uma única peça subjacente de história.
9. Recordação Hierárquica
O otimizador tenta atender às necessidades de memória usando a camada útil mais barata.
Uma pergunta ampla pode exigir apenas um Fio Narrativo.
Uma pergunta mais precisa pode descer automaticamente por:
Fio → Episódio → Evidência Atômica
Isso ajuda a preservar detalhes sem forçar cada detalhe em cada prompt.
Recuperação Reversível: JMO10 Escrow
O Cenário também carrega um ponto de verificação de recuperação limitado.
A camada de recuperação usa:
serialização compacta → LZW12 → Base64 → checksum
Se o estado privado de runtime desaparecer enquanto o ponto de verificação anterior do Cenário permanecer disponível, o otimizador pode reconstruir a memória a partir desse ponto de verificação.
Conceitualmente:
Cenário → JMO10 Escrow → Fatos Atômicos / Episódios Arquivados → Dossiês Semânticos → Grafo Temporal → Fios Narrativos
Dados de escrow corrompidos são rejeitados em vez de convertidos em memória fabricada.
O JMO10 também pode ler formatos de escrow mais antigos JMO3–JMO9 para migração e recuperação.
Gerenciamento Automático de Contexto
O objetivo não é despejar todo o cofre de memória em cada geração.
Armazenamento e recordação são deliberadamente separados.
O motor ajusta automaticamente os orçamentos de recordação e recuperação com base no espaço disponível e no tipo de informação atualmente necessária.
Uma continuação simples precisa de menos memória do que uma pergunta detalhada sobre causalidade, cronologia ou um relacionamento que abrange centenas de mensagens.
Se necessário, o otimizador reduz o detalhe antes de transbordar seu envelope de trabalho interno.
Proteções Internas
Estas são heurísticas do projeto, não limites oficiais alegados do JanitorAI.
Limite flexível estimado combinado de Personalidade + Cenário: 4.000 tokens
Fragmentos de tópico máximos: 512
Grafo temporal: 384 nós / 768 arestas
Arquivos episódicos: 160
Fios narrativos: 192
Orçamentos de recordação e escrow: automaticamente adaptativos
Estes existem para manter o sistema de memória limitado e previsível em vez de permitir crescimento descontrolado.
Segurança para Roleplay Longo & Higiene de Memória
O motor inclui várias salvaguardas conservadoras desenvolvidas ao longo do projeto:
consolidação de duplicatas exatas;
síntese de quase-duplicatas quando apropriado;
substituição do estado atual sem destruir cegamente o histórico útil;
filtragem de perguntas para que perguntas não se tornem automaticamente fatos estabelecidos;
detecção conservadora de causalidade;
resolução de entidades ciente de ambiguidade;
esquecimento direcionado em linguagem natural;
rejeição de ponto de verificação de recuperação corrompido;
recordação histórica ciente de relevância;
isolamento de preenchimento para que um "Ok." genérico não arraste arquivos não relacionados para o contexto;
preservação da evidência atômica por trás de resumos de nível superior;
poda limitada de memória e grafo;
migração automática de estados de otimizador mais antigos quando disponíveis.
Projetado para Roleplay de Longa Duração
O Janitor Memory Optimizer é particularmente útil para roleplays envolvendo:
relacionamentos de desenvolvimento lento;
elenco com vários personagens;
mistérios e investigações;
missões e objetivos;
alianças em mudança;
conflitos de longa duração;
inventários persistentes ou objetos importantes;
locais recorrentes;
desenvolvimento de personagem;
histórias que abrangem centenas ou milhares de turnos.
Validação & Teste de Estresse
A v1.0.0 não foi lançada após uma simples verificação de sintaxe. Ela passou por suítes dedicadas de regressão, endurecimento, recuperação e estresse de longo horizonte.
Validação Estática / do Pacote do Criador
Verificação de sintaxe do Node: PASS
Validador ES5 conservador: PASS
Erros: 0
Avisos: 0
Tamanho do runtime: 191.418 / 400.000 bytes
Testes de Invariante da Superfície de Saída
Sem
script_output: PASSSem gravações no histórico do chat: PASS
last_messagepermanece inalterado: PASSmessage_countpermanece inalterado: PASSSem gravações de memória em
example_dialogs: PASSNenhum bloco de memória ativa adicionado à Personalidade: PASS
Exatamente um destino de memória visível ao LLM — Cenário: PASS
Nenhuma sintaxe de comando do usuário necessária ou exposta: PASS
Suíte de Regressão
21 asserções direcionadas: PASS
A cobertura incluiu:
cenário de 109 turnos;
consolidação episódica;
fios narrativos;
recordação ampla de fios;
aprofundamento exato/histórico;
isolamento de preenchimento;
recuperação de perda de estado;
compatibilidade de migração de versão mais antiga.
Suíte de Endurecimento Final
23 asserções adicionais: PASS
Esta suíte cobriu especificamente:
arquitetura somente de Cenário;
migração de estado ao vivo v0.9 para v1.0;
recuperação de escrow legado JMO9;
evidência atômica sobrevivendo à recuperação legada;
rejeição segura de escrow corrompido;
esquecimento direcionado em linguagem natural;
preservação de memórias semânticas não relacionadas durante esquecimento direcionado.
Teste de Estresse de 500 Turnos
Corpus de teste:
500 turnos de população + 60 consultas de memória em linguagem natural + 3 recuperações completas de perda de estado privado.
Fatos antes da recuperação: 42
Fatos após 3 recuperações: 42
Episódios antes / depois: 10 / 10
Fios Narrativos antes / depois: 5 / 5
Recuperações completas de perda de estado: 3 / 3 PASS
Teste de Estresse de Longo Horizonte de 2.000 Turnos
Um teste muito maior também foi executado:
2.000 turnos de população + 60 consultas naturais + 3 recuperações completas de perda de estado.
Fatos antes / depois da recuperação: 61 / 61
Episódios antes / depois: 40 / 40
Fios Narrativos antes / depois: 5 / 5
Recuperações completas de perda de estado: 3 / 3 PASS
Construções de fios: 195
Reutilizações de assinatura de fios: 1.927
Construções de grafo: 201
Reutilizações de grafo: 1.860
Isso demonstra que as estruturas derivadas são fortemente reutilizadas em vez de reconstruídas cegamente a cada turno.
Otimização de Desempenho
No mesmo harness Node local de 500+60:
linha de base v0.9: aproximadamente 6,49 segundos
v1.0 otimizada: aproximadamente 3,87 segundos
Redução relativa: aproximadamente 39%
Este benchmark mede o script em um harness de teste de VM Node local. É uma medição relativa de regressão/desempenho para o próprio script, não uma afirmação sobre a latência do servidor do JanitorAI.
Compatibilidade & Migração
A v1.0.0 grava o formato de recuperação JMO10 atual.
Ele pode ler pontos de verificação de escrow legados JMO3 até JMO9.
A migração de estados anteriores do Janitor Memory Optimizer é suportada quando o estado mais antigo necessário ainda está disponível.
Para uma instalação nova, basta usar a v1.0.0.
Vibe-Coded com ChatGPT 5.6
Sim, este projeto foi vibe-coded com o ChatGPT 5.6.
O motor foi desenvolvido iterativamente por meio de design, teste, depuração, teste de estresse e revisões arquitetônicas repetidas dirigidas por humanos, com o ChatGPT 5.6 auxiliando no código.
Ele evoluiu através de múltiplos protótipos: de um injetor básico de memória seletiva para um cofre endereçado por conteúdo, sistema de recuperação reversível, hierarquia de memória semântica, grafo temporal, resolvedor de entidades, arquivo episódico e motor de fios narrativos.
O lançamento final foi então submetido a suítes automatizadas de regressão e estresse em vez de ser publicado simplesmente porque o código gerado "parecia certo."
Este é um projeto comunitário independente. Não é um produto oficial da OpenAI ou do JanitorAI, e mencionar o ChatGPT 5.6 descreve o processo de desenvolvimento, não uma certificação ou endosso oficial.
Por Que Usá-lo?
Porque a memória não deve se tornar outra mecânica de jogo que o roleplayer precisa gerenciar.
Você não deveria ter que pausar uma cena para digitar:
/save_memory relationship Nadia trust -1
Você deveria simplesmente poder escrever:
Depois do que Nadia fez, não acho que posso mais confiar nela.
e continuar a história.
Essa é a filosofia de design por trás do Janitor Memory Optimizer.
O processamento de memória deve acontecer em segundo plano. O chat deve permanecer um chat. As definições de personagem devem carregar a memória de trabalho. O LLM deve receber a menor quantidade útil de contexto para o momento atual.
Em Resumo
Plug & play.
Totalmente passivo.
Sem comandos.
Sem interface de memória.
Sem mensagens falsas de chat.
Memória visível ao LLM somente no Cenário.
Lembrar / esquecer em linguagem natural.
Evidência atômica.
Cofre de memória com hash.
Dossiês semânticos.
Grafo temporal e causal.
Inteligência de entidades conservadora.
Memória adaptativa quente / morna / fria.
Consolidação episódica de longo prazo.
Fios narrativos persistentes.
Recordação hierárquica com aprofundamento em evidências.
Escrow de recuperação JMO10 reversível.
Suporte a recuperação legada.
Orçamento automático de contexto.
Testado sob estresse com mais de 2.000 turnos.
3/3 recuperações completas de perda de estado em ambas as principais suítes de estresse.
0 erros de validação ES5.
0 avisos de validação ES5.
Cole. Anexe. Faça roleplay normalmente.
Deixe o personagem lembrar.
Criado 18 de ago.
Atualizado 18 de ago.
Publicado 18 de ago.
proxy permitido